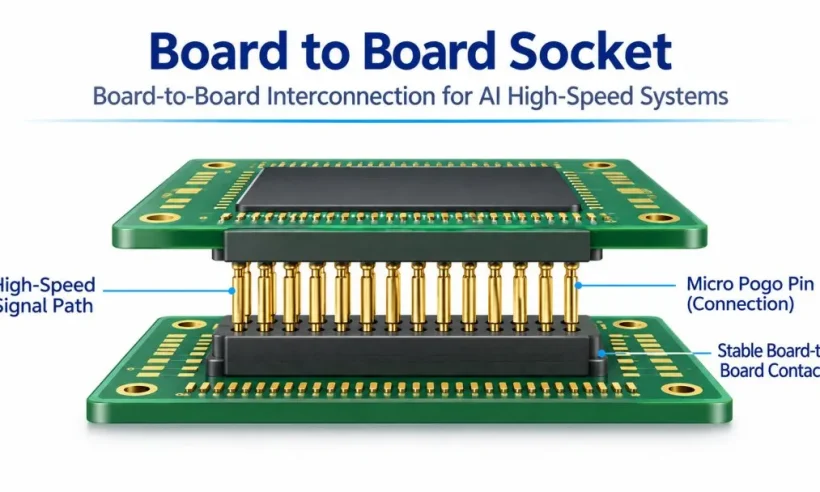
随着 AI 算力持续升级,AI 服务器、高速光模块内部信号速率不断冲高,信号完整性、互连密度与装配空间,已经成为下一代算力硬件结构设计的核心瓶颈。传统互连方案受堆叠高度、引脚排布、寄生参数约束,很难同时兼顾高频性能、小型化堆叠与装配公差适配需求。Board to Board Socket 作为实现两块 PCB 板之间对接互连的器件,依托低矮化结构设计,在有限垂直堆叠空间内搭建稳定的信号通道,是高密度高速互连架构中的关键组件。
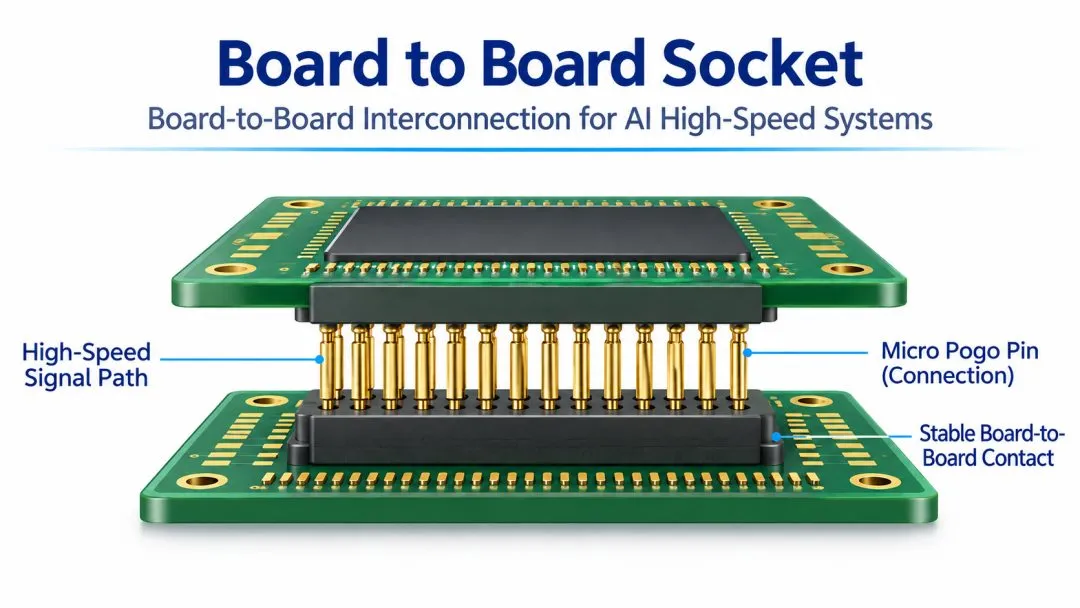
该类 Socket 面向高频信号传输场景开发,能够有效降低链路插入损耗与通道串扰,严格匹配高速互连系统对阻抗连续性、接触可靠性的严苛标准。在 GPU、光模块等硬件方案中,Board to Board Socket 可以优化板间堆叠布局,缩短信号传输路径,减少阻抗不连续点带来的信号反射与眼图恶化,同时兼容板级装配浮动公差,提升整机组装良率,助力系统实现更高带宽、更低时延的信号传输能力。
高频互连的性能上限,不仅取决于接触结构设计,材料选型、接触力学、镀层工艺与量产一致性同样决定方案能否从样品落地批量。拓普联科深耕高速精密互连领域,提供 Low Profile Socket、Board to Board Socket 等互连方案,针对 AI 高速场景完成接触结构、镀层材料与弹性结构专项优化,兼顾高频电气性能、长期反复插拔稳定性与大批量生产一致性,为 AI 算力硬件工程师提供可落地、可验证的互连选型方向,支撑 112Gbps、224Gbps、448Gbps 等高速信号链路开发。